לחסום את ה-AI או לא? השורה החדשה ב-robots.txt, ומה אסור לחסום אם רוצים להופיע ב-ChatGPT ובגוגל
ב-30.10.2026 גוגל, OpenAI ומיקרוסופט הודיעו שיכבדו שורה ב-robots.txt שאומרת "לא לאמן על התוכן שלי". מה היא עושה, ומה אסור לחסום כדי להישאר בתשובות AI.
דניאל נחמיה
מומחה AI ועיצוב דיגיטלי
שורה אחת שכולם מדברים עליה
ב-30 באוקטובר 2026 גוגל, OpenAI ומיקרוסופט הודיעו שיתחילו לכבד סימון משותף בקובץ robots.txt, שאומר בשפה אחת לכל חברות ה-AI: "אל תאמנו מודלים על התוכן של האתר הזה". ההצעה עצמה נכתבה בידי מהנדס של Anthropic, והחברה כתבה שכבר התחילה ליישם אותה.
על פניו זה פשוט: מוסיפים שורה, והתוכן שלכם לא נכנס לאימון. בפועל, בעלי אתרים עסקיים שממהרים "לחסום את ה-AI" עלולים לגלות שהם נעלמו בדיוק מהמקומות שבהם הלקוחות שלהם מחפשים היום: התשובות של ChatGPT, של ג׳מיני ושל ה-AI Overviews בגוגל.
לפני שנוגעים בקובץ, שלושה דברים:
- זה עוד לא פועל. גוגל מדברת על 2027, מיקרוסופט על פברואר 2027, ו-OpenAI על "החודשים הקרובים".
- זה לא חוסם סריקה. זו הצהרת העדפה על אימון בלבד, לא הוראה לבוטים לא להיכנס.
- בגוגל זה גם מנתק ציטוטים בג׳מיני. אצל גוגל השורה החדשה שקולה לחסימת Google-Extended, ואותה חסימה מוציאה את האתר גם מהתשובות של אפליקציית ג׳מיני.
במדריך הזה נפריד בין שלושה דברים שכולם מערבבים: אימון, תשובות AI וחיפוש. נראה מה כל חברה הבטיחה, ונגיע לשלוש תצורות מוכנות להעתקה לפי סוג העסק.
מה בדיוק הוכרז
הבסיס הוא טיוטה שהוגשה ל-IETF, הגוף שמגדיר תקני אינטרנט, בשם "Training Preference Signal". היא מגדירה "שם בוט" מיוחד, __usage_ai-training, שלא שייך לאף סורק אמיתי. כשהוא מופיע בקובץ, כל חברת AI שהתחייבה לסימון יודעת מה בעל האתר רוצה לגבי אימון, בלי שהוא יצטרך להכיר את השמות של עשרות הבוטים השונים.
| חברה | מה הודיעה | מתי זה נכנס לתוקף |
|---|---|---|
| גוגל | תכבד את הסימון, ותתייחס אליו כמו לחסימת Google-Extended | "ב-2027" לפי הבלוג, "בתחילת 2027" לפי תיעוד הסורקים |
| OpenAI | תכבד אותו לאימון של מודלי יסוד, לצד הבוטים הקיימים | "בחודשים הקרובים", בלי תאריך |
| מיקרוסופט (Bing) | תכבד אותו, וגם מוסיפה תגיות לרמת העמוד | מתחיל לחול ב-1.2.2027, על כל עמוד בסריקה הבאה שלו |
| Anthropic | התחילה ליישם, ואמרה שהפריסה בכל השירותים תיקח זמן | חלקי, מ-30.10.2026 |
| מטא, אפל, אמזון, Perplexity | אין התחייבות | לא ידוע |
שימו לב לשורה האחרונה. לפי דיווחים בתקשורת, מטא אמרה בתגובה שסימון משותף הוא "צעד חשוב", אבל לא התחייבה לכבד אותו. כלומר, גם מי שמוסיף את השורה עדיין צריך את החסימות הישנות לפי שם בוט.
שלושה דברים שונים: אימון, תשובות AI וחיפוש
זו הנקודה שהכי חשוב להבין, כי כאן נעשות הטעויות.
- אימון: החברה אוספת את התוכן כדי ללמד מודל עתידי. התוכן שלכם הופך לחלק מ"הידע" של המודל, בלי קישור ובלי קרדיט.
- תשובות AI (grounding): כשמשתמש שואל שאלה, הבוט ניגש לאתר בזמן אמת, קורא את העמוד ומצטט אותו עם קישור. זה ה-GEO: להופיע כמקור בתשובה.
- אינדקס חיפוש: הסריקה הרגילה של גוגל ו-Bing, שעליה בנויות גם התוצאות הרגילות.
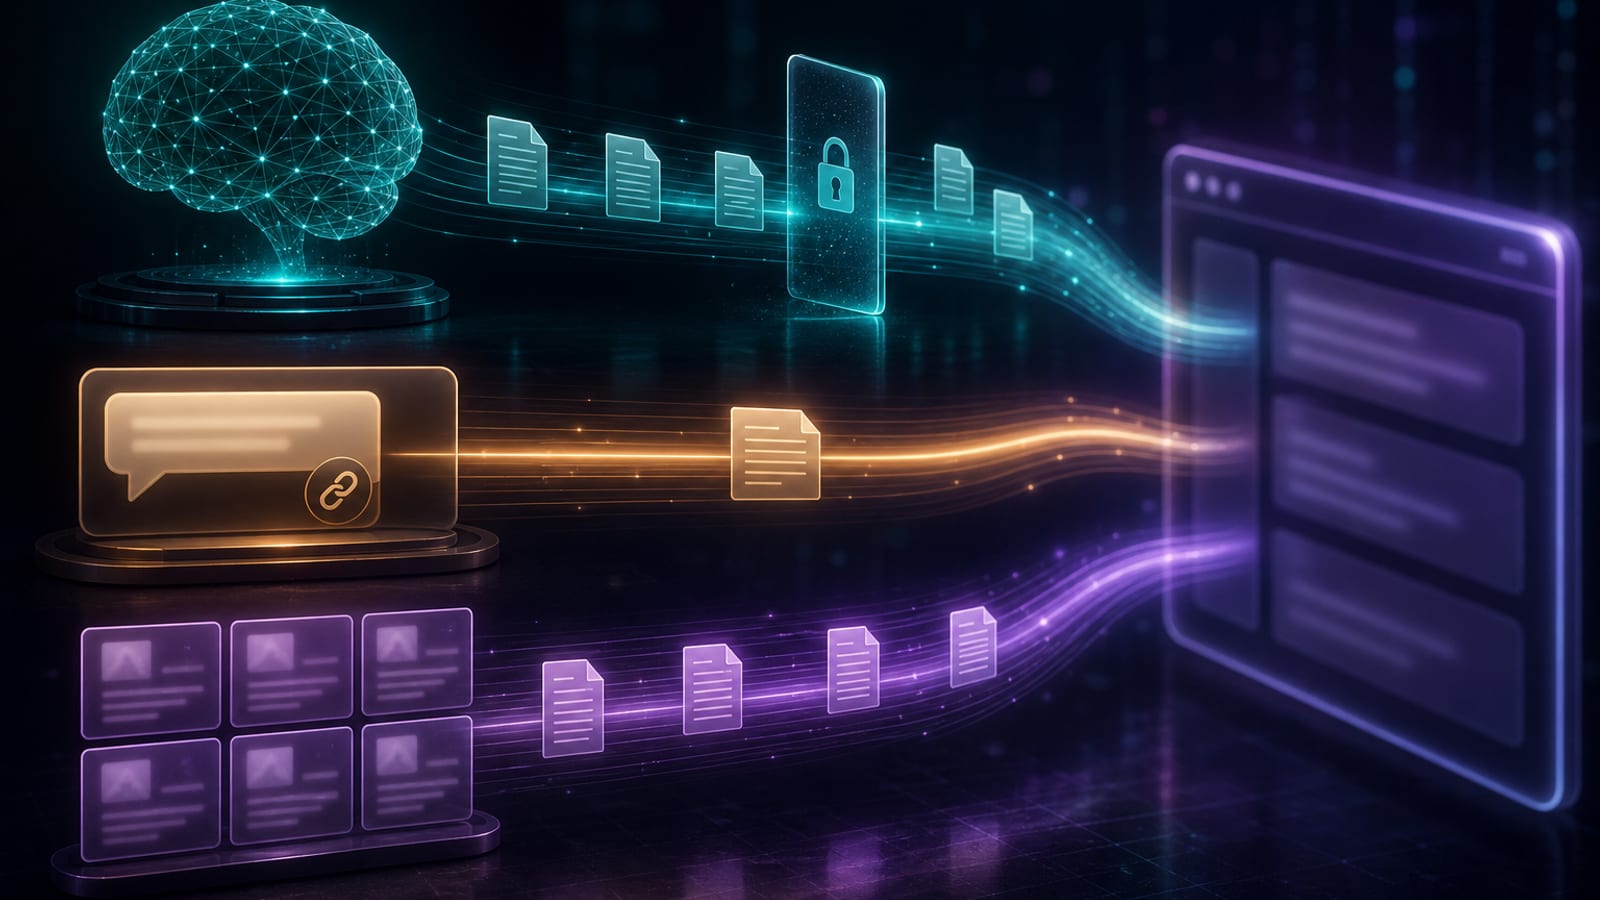
לכל חברה יש בוטים נפרדים לכל תפקיד, והשורה החדשה נוגעת רק בראשון:
| חברה | אימון | תשובות AI וציטוטים | חיפוש רגיל |
|---|---|---|---|
| גוגל | Google-Extended | אפליקציית ג׳מיני: גם Google-Extended. AI Overviews ו-AI Mode: Googlebot | Googlebot |
| OpenAI | GPTBot | OAI-SearchBot (חיפוש ב-ChatGPT), ChatGPT-User (כשמשתמש מבקש עמוד) | אין |
| Anthropic | ClaudeBot | Claude-SearchBot, Claude-User | אין |
| מיקרוסופט | הסימון המשותף, או תגית בעמוד | תגית ai-grounding ברמת העמוד | Bingbot |
| Perplexity | לפי Perplexity, לא מאמנת מודלי יסוד על סריקה | PerplexityBot, Perplexity-User | PerplexityBot |
| אפל | Applebot-Extended | Applebot | Applebot |
⚠️ הכלל החשוב במדריך: אם אתם רוצים שהעסק יופיע בתשובות של ChatGPT, Perplexity וגוגל, אל תחסמו את Googlebot, Bingbot, OAI-SearchBot, ChatGPT-User, PerplexityBot, Perplexity-User, Claude-SearchBot, Claude-User ו-Applebot. לפי OpenAI, אתר שחוסם את OAI-SearchBot פשוט לא יוצג בתשובות החיפוש של ChatGPT.
איך נראית השורה
אין כאן פקודה חדשה. זו קבוצה רגילה ב-robots.txt, עם "שם בוט" מיוחד. הדוגמה מתוך הטיוטה עצמה: לא לאמן על שום דבר באתר, חוץ מערכת העיתונות.
User-Agent: __usage_ai-training
Disallow: /
Allow: /press-kit/
ארבעה כללים מהטיוטה שכדאי להכיר:
- הכוכבית לא נחשבת. קבוצה של
User-Agent: *לא מבטאת שום העדפה על אימון. חייבים קבוצה עם השם המיוחד. - זו לא הוראת סריקה. מי שרוצה שבוט מסוים לא ייכנס בכלל, ממשיך לחסום אותו בשמו.
- הספציפי גובר. אם כתבתם כלל לבוט של חברה מסוימת, למשל GPTBot או Google-Extended, הכלל הזה גובר על הסימון המשותף.
- הרגע הקובע הוא רגע הסריקה. ההעדפה שנחשבת היא זו שהייתה בקובץ כשהעמוד נאסף. זה לא חל אחורה על מודלים שכבר אומנו.
המלכודת של ג׳מיני
כאן גוגל עושה משהו שאתרים עסקיים חייבים להכיר. אצלה, השם החדש מתפרש כמו חסימה של Google-Extended, ו-Google-Extended משמש לשני דברים: גם לאימון וגם לעיגון התשובות באפליקציית ג׳מיני (ובשירותי Vertex AI).
המשמעות: אתר שמוסיף את השורה החדשה, בלי להזכיר את Google-Extended במפורש, יפסיק להיות מקור לציטוטים באפליקציית ג׳מיני. אין בגוגל דרך להפריד בין השניים. מי שרוצה ציטוטים בג׳מיני חייב לאפשר את Google-Extended, ובכך מאפשר גם אימון.
מה כן נשאר בטוח: ה-AI Overviews וה-AI Mode בחיפוש של גוגל עובדים על Googlebot, ולא על Google-Extended. גוגל גם כותבת במפורש ש-Google-Extended לא משפיע על ההופעה בחיפוש ולא משמש כאות דירוג.
💡 בשורה התחתונה: הסימון החדש לא יוריד אתכם מגוגל ולא מה-AI Overviews. הוא כן עלול להוריד אתכם מהתשובות של אפליקציית ג׳מיני, אם לא תוסיפו אישור מפורש ל-Google-Extended.
מה השורה לא עושה
- לא מחייבת משפטית. OpenAI מגדירה את זה "מאמץ וולונטרי", ומיקרוסופט כותבת שזה לא יוצר הסכם רישוי או תשלום.
- לא חלה אחורה. מודלים שכבר אומנו על התוכן שלכם נשארים כמו שהם.
- לא עוסקת בתשובות AI. היא מדברת רק על אימון. ברשימת הדיון של IETF כבר עלתה השאלה למה אין סימון מקביל לשימוש בתשובות.
- השם עוד עשוי להשתנות. אחד מראשי קבוצת העבודה ב-IETF כתב ב-5.11 ש-
__usage_ai-trainingהוא "לא הצורה הסופית", ושהשם הסופי כנראה יהיה__usage_train-ai. מי שמוסיף את השורה עכשיו צריך לזכור לעדכן אותה.
גם התגובות לא היו חגיגיות. חלק מהיוצרים והמו"לים ברשימת הדיון של IETF טענו שזה מנרמל מנגנון של "תבקשו להוציא אתכם" במקום "תבקשו רשות", ואתרי SEO ציינו שסימון משותף לא פותר את בעיית התנועה שה-AI לוקח מאתרי תוכן.
אז לחסום אימון או לא?
אין תשובה אחת. זה תלוי במה שהאתר מוכר:
| סוג האתר | המלצה לגבי אימון | למה |
|---|---|---|
| נותן שירות (משרד, סוכנות, קליניקה) | לא למהר לחסום | האתר הוא כלי שיווק. ככל שהמודלים מכירים את העסק טוב יותר, כך גדל הסיכוי שיזכירו אותו |
| חנות אונליין | לא לחסום את דפי המוצר | נתוני מוצר מדויקים הם ה-SEO החדש בעידן של קניות דרך AI |
| אתר תוכן שמתפרנס מתנועה | לשקול לחסום אימון, לא תשובות | התוכן הוא המוצר. ציטוט עם קישור עדיף על "ידע" בלי קרדיט |
| תוכן בתשלום, קורסים, מאגרי מידע | לחסום אימון, ולחסום סריקה של האזורים הסגורים | אסור שהמוצר בתשלום יהפוך לתשובה חינמית |
| עיתונות ומדיה | לחסום אימון, ולשקול הסכמי רישוי | כאן יש ערך מסחרי לתוכן, וכדאי לנהל אותו |
לרוב העסקים שאנחנו עובדים איתם, התשובה היא לא לגעת בחסימות אימון כרגע, ולוודא שאף בוט של תשובות או חיפוש לא נחסם בטעות. את זה עשינו גם באתר שלנו: ה-robots.txt של DNA Media מאפשר את כל הבוטים, ובמפורש את בוטי ה-AI העיקריים, כולל בוטי האימון, כי עבורנו להיות מוכרים למודלים שווה יותר מהסיכון.
שלוש תצורות מוכנות להעתקה
מוסיפים את השורות לקובץ ה-robots.txt הקיים ולא מחליפים אותו, כדי לא למחוק חסימות שכבר יש בו, למשל של עמודי ניהול או של עמוד הסל. גם שורת ה-Sitemap שכבר יש לכם נשארת.
תצורה א: עסק שרוצה מקסימום חשיפה ב-AI
אין צורך בשורה החדשה. מספיק לא לחסום, ואפשר לאשר במפורש את הבוטים החשובים:
User-Agent: *
Allow: /

User-Agent: OAI-SearchBot
Allow: /

User-Agent: ChatGPT-User
Allow: /

User-Agent: Claude-SearchBot
Allow: /

User-Agent: PerplexityBot
Allow: /

User-Agent: Google-Extended
Allow: /

Sitemap: https://www.example.co.il/sitemap.xml
תצורה ב: בלי אימון, אבל עם ציטוטים
מסמנים "לא לאמן", חוסמים את בוטי האימון בשמם (לחברות שעוד לא תומכות בסימון, או שהתמיכה שלהן עדיין חלקית), ומשאירים את בוטי התשובות פתוחים. CCBot הוא הסורק של Common Crawl, מאגר פתוח שחברות רבות מאמנות עליו, ו-Meta-ExternalAgent הוא הסורק של מטא. את Amazonbot לא הוספנו, כי אמזון משתמשת בו גם לתשובות של Alexa. את Google-Extended משאירים מאושר, כדי לא לאבד את ג׳מיני. זה אומר שגוגל עדיין תוכל לאמן, וזה המחיר של ציטוטים בג׳מיני.
User-Agent: __usage_ai-training
Disallow: /

User-Agent: GPTBot
Disallow: /

User-Agent: ClaudeBot
Disallow: /

User-Agent: CCBot
Disallow: /

User-Agent: Applebot-Extended
Disallow: /

User-Agent: Meta-ExternalAgent
Disallow: /

User-Agent: Google-Extended
Allow: /

User-Agent: *
Allow: /
תצורה ג: אתר תוכן שלא רוצה אימון בכלל
כמו תצורה ב, אבל גם Google-Extended נחסם. גוגל עדיין תציג את האתר בחיפוש וב-AI Overviews, אבל הוא לא יצוטט באפליקציית ג׳מיני.
User-Agent: __usage_ai-training
Disallow: /

User-Agent: Google-Extended
Disallow: /

User-Agent: GPTBot
Disallow: /

User-Agent: ClaudeBot
Disallow: /

User-Agent: CCBot
Disallow: /

User-Agent: Applebot-Extended
Disallow: /

User-Agent: Meta-ExternalAgent
Disallow: /

User-Agent: *
Allow: /
⚠️ בכל שלוש התצורות, אל תשתמשו ב-
nosnippetעל עמודים שאתם רוצים שיופיעו בתשובות. גוגל כותבת שכדי להופיע בפיצ׳רי ה-AI שלה, עמוד צריך להיות באינדקס וזכאי להציג קטע טקסט בתוצאות.
אם האתר יושב מאחורי Cloudflare
הרבה אתרים בישראל, כולל שלנו, מוגשים דרך Cloudflare, ושם יש עוד שכבה:
- ל-Cloudflare יש סימון משלה, בשם Content Signals (למשל
Content-signal: search=yes, ai-train=no). הוא נכתב תחתUser-Agent: *, והטיוטה החדשה קובעת שהכוכבית לא נחשבת. כלומר, אתר שמסתמך רק על ההגדרה של Cloudflare לא מבטא העדפה לפי הסימון המשותף. אפשר להשתמש בשניהם יחד. - בדקו את הגדרות הבוטים בחשבון. ב-Cloudflare יש הגדרות שחוסמות סורקי AI ברמת השרת, עוד לפני שהם קוראים את robots.txt. אתר שהופעלה בו חסימה כזו יכול להיעלם מתשובות AI גם כשהקובץ עצמו מאשר הכול.
- Search Console עשוי להתריע על שורות Content-Signal כ"תחביר לא מוכר". לפי Cloudflare, אין לזה השפעה על הקידום.
רשימת בדיקה: שבעה דברים לבדוק השבוע
- פתחו את הקובץ החי. כתובת האתר ואחריה
/robots.txt. חפשו חסימות של Googlebot, Bingbot, OAI-SearchBot, ChatGPT-User, PerplexityBot, Perplexity-User, Claude-SearchBot, Claude-User או Applebot. - בדקו את הגדרות הבוטים ב-Cloudflare או בחברת האחסון, אם יש לכם.
- בדקו את הגדרת ה-AI ב-Search Console. יש בה היום בקרה שמוציאה את האתר מפיצ׳רי ה-AI של החיפוש. אל תפעילו אותה אם אתם רוצים להופיע ב-AI Overviews.
- חפשו
nosnippetו-noarchiveבקוד. אםnosnippetמופיע בעמודים שאתם רוצים שיופיעו בתשובות, הסירו אותו. ב-Bing, ה-NoArchive וה-NoCache הישנים ימשיכו לשמש כהעדפת AI רק עד 1 במרץ 2027, ואחר כך יוחלפו בתגיות חדשות ברמת העמוד. - החליטו לפי הטבלה למעלה אם בכלל לחסום אימון.
- אם הוספתם את השורה החדשה, קבעו תזכורת לתחילת 2027 לבדוק אם השם השתנה.
- מדדו. אחרי כל שינוי, בדקו אם האתר עדיין מופיע כשמחפשים אתכם ב-ChatGPT, ב-Perplexity וב-AI Overviews.
רוצים להבין איך אתר נבנה מראש כך שגוגל יבין אותו? כתבנו על זה במדריך איך לבנות אתר מותאם לקידום בגוגל, ועל הצד של חנויות אונליין במדריך AI לקמעונאות ולחנויות אונליין.
שאלות נפוצות
מה זה __usage_ai-training?
זה "שם בוט" מיוחד שמוגדר בטיוטה שהוגשה ל-IETF ב-30.10.2026. כשהוא מופיע בקבוצה ב-robots.txt עם Disallow, הוא אומר לכל חברת AI שהתחייבה לסימון שלא לאמן מודלים על התוכן. הוא לא שייך לאף סורק אמיתי ולא חוסם סריקה.
אם אוסיף את השורה, האתר ייעלם מגוגל?
לא. גוגל מתייחסת אליה כמו לחסימת Google-Extended, וכותבת במפורש ש-Google-Extended לא משפיע על ההופעה בחיפוש ולא משמש כאות דירוג. גם ה-AI Overviews עובדים על Googlebot. מה שכן עלול להיפגע הוא הציטוטים באפליקציית ג׳מיני.
האם השורה כבר עובדת?
עדיין לא באופן מלא. Anthropic התחילה ליישם, OpenAI אמרה "בחודשים הקרובים", גוגל מדברת על 2027, ו-Bing מתחילה ב-1 בפברואר 2027. מטא, אפל, אמזון ו-Perplexity לא התחייבו.
האם חסימת אימון תוריד אותי מהתשובות של ChatGPT?
לא, אם לא חוסמים את OAI-SearchBot ו-ChatGPT-User. האימון נעשה בידי GPTBot, וכל אחת מההגדרות של OpenAI עצמאית. מי שחוסם את OAI-SearchBot, לעומת זאת, לא יוצג בתשובות החיפוש של ChatGPT.
האם זה מחייב את החברות משפטית?
לא. זו הצהרת העדפה וולונטרית. היא לא יוצרת הסכם רישוי ולא חלה על מודלים שכבר אומנו. עסקים שהתוכן שלהם הוא המוצר צריכים לשקול גם צעדים טכניים (חסימת סריקה, אזורים סגורים) וגם משפטיים.
מה עדיף לעסק נותן שירות?
ברוב המקרים לא לחסום אימון בכלל, ולהתמקד בכך שבוטי התשובות והחיפוש נכנסים בלי בעיה. האתר של עסק נותן שירות הוא כלי שיווק, ויש ערך בכך שהמודלים מכירים אותו.
אני ב-Cloudflare. זה משנה משהו?
כן. בדקו שהגדרות הבוטים לא חוסמות סורקי AI ברמת השרת. בנוסף, הסימון Content Signals של Cloudflare נכתב תחת הכוכבית, ולכן לא נחשב כהעדפה לפי הטיוטה החדשה. מי שרוצה לחסום אימון צריך להוסיף את הקבוצה המיוחדת בנפרד.
האם השם של השורה עוד ישתנה?
ייתכן. אחד מראשי קבוצת העבודה ב-IETF כתב שהשם הנוכחי הוא לא הסופי, ושהסופי כנראה יהיה __usage_train-ai. הטיוטה היא עדיין הגשה אישית, ולא תקן מאושר.
לסיכום
השורה החדשה היא צעד חשוב לבעלי תוכן, אבל לרוב העסקים היא לא הדבר הדחוף. הסיכון האמיתי הוא ההפוך: אתר שחוסם בטעות את הבוטים שמביאים אותו לתשובות של ChatGPT, Perplexity וגוגל, ונעלם בדיוק מהמקום שבו הלקוחות מחפשים.
ב-DNA Media אנחנו בונים ומקדמים אתרים כך שיופיעו גם בגוגל וגם בתשובות של מנועי ה-AI: מבנה נכון, נתונים מובנים, robots.txt שנבדק, ומדידה של ההופעה בפועל. אם אתם לא בטוחים מה מוגדר אצלכם, קידום אתרים בגוגל ובמנועי AI הוא בדיוק המקום להתחיל, וכל אתר שאנחנו מקימים בבניית אתרים לעסקים יוצא עם התשתית הזו מהיום הראשון.
דברו איתנו או התקשרו ל-052-3955056, ונבדוק יחד מה הקובץ שלכם אומר עליכם.
מאמרים קשורים
 בניית אתרים
 עם AI ב-2026 — מ-0 לאתר מוכן בשעות
מדריך מלא לבניית אתרים עם כלי בינה מלאכותית. Loveable, Bolt, v0, Claude Code — איך בונים אתר מקצועי בלי ידע בתכנות, ומתי כן צריך מפתח.
 בניית אתרים
בניית אפליקציות אתרים וכלים ללא קוד (No-Code | Vibe Coding) בעזרת Lovable: מדריך סקירה מלא 2026
מדריך Lovable (לובאבל) בעברית 2026: איך הופכים טקסט לאפליקציה או אתר בלי שורת קוד — פרומפטים, Supabase, Lovable Cloud, מחירים, השוואה לכלים אחרים ושאלות נפוצות.
 בניית אתרים
איך לבנות אתר מותאם לקידום בגוגל SEO
איך כדאי לבנות אתר אינטרנט בצורה כזו שימצאו אותך בגוגל, המאמר מדבר ומסביר על הצורה הטובה ביותר לבנות אתר אינטרנט מבוסס קידום אתרים SEO